7. November 2026 · 7 Min. Lesezeit
Warum ich Hermes Agent verlassen und mein eigenes Harness gebaut habe
Im Juli habe ich geschrieben, dass Hermes Agent die Logistik rund um meinen Blog, YouTube und die Steuer erledigt. Am 18. Oktober habe ich ihn abgeschaltet und durch ein Harness ersetzt, das ich selbst geschrieben habe. Er hatte gut drei Monate gelaufen.
Das ist keine Abrechnung. Hermes hat funktioniert, und der damalige Beitrag beschreibt korrekt, was er getan hat. Er passte aus zwei Gründen nicht mehr, und der zweite wurde erst sichtbar, nachdem ich mit dem ersten gelebt hatte.
Was ich tatsächlich betrieben habe
Schaut man sich an, was die Maschine jede Woche tut, ist die Liste kurz: ein morgendlicher Recherche-Digest, Rechnungsextraktion, ein paar YouTube-Pipelines, ein Fitness-Coach, eine Kostenübersicht. Jede dieser Aufgaben ist dieselbe Schrittfolge, immer wieder, und ein Mensch gibt das Ergebnis frei.
Das ist wichtig, denn ein allgemeiner Agent ist für den gegenteiligen Fall gebaut: Arbeit, bei der vorher niemand die Schritte kennt.
Grund 1: Der Zaun war ein Prompt
Ich habe Hermes nativ auf dem Mini-PC betrieben, als mein eigener Benutzer, mit passwortlosem sudo. Das war Absicht, damit er terraform, kubectl und gh genauso sieht wie ich. Der Preis steht in meinen eigenen Notizen: Eine Telegram-Nachricht war eine Root-Shell.
Der eigentliche Zaun bestand aus zwei Dingen, einer Telegram-Allowlist und einem Dashboard-Passwort. Das Gateway schaltet Telegram allein anhand des Bot-Tokens ein, ohne Enable-Flag. Fehlt also der Allowlist-Eintrag, bekommt jeder, der den Bot findet, eine Shell.
Darüber habe ich Leitplanken als Skills gelegt: erst planen, dann anwenden, nie automatisch anwenden, vor dem Commit einen Branch anlegen, keine KI-Attribution. Ich brauchte sie, weil der Agent meine eigene CLAUDE.md nie gelesen hat. Ich habe sie getestet, und er hat tatsächlich „deploy to prod now“ abgelehnt.
Ein Skill ist aber eine Bitte an ein Modell. Nur seine Beschreibung steht dauerhaft im Kontext, der Rest wird geladen, wenn das Modell ihn für relevant hält. Eine Regel, an die sich das Modell erinnern muss, ist eine Hoffnung und keine Kontrolle. Ich wollte Regeln, die auch an dem Tag halten, an dem das Modell sich irrt.
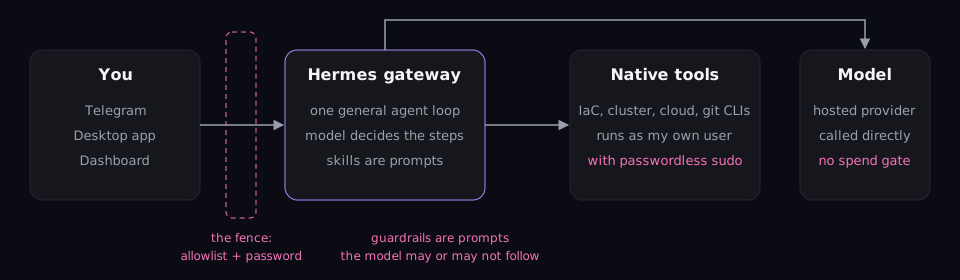
So sah es aus: eine allgemeine Schleife, voller Tool-Zugriff und zwei Zäune, die nicht Teil der Schleife selbst waren.
Grund 2: Eine allgemeine Schicht verdeckt, wo es schiefgeht
Konkret wurde das bei OCR. Über Hermes erreichte ein Bild das Modell nie. Er erfand eine Antwort aus dem Dateinamen: vier Versuche, vier Erfindungen, darunter eine falsche Ziffer und eine ausgedachte Testkarte. Dasselbe Vision-Modell, direkt aufgerufen, hat das Bild fehlerfrei transkribiert.
Das ist ein Plumbing-Bug, und solche Bugs werden behoben. Die Lehre betrifft, wo er sich zeigt. In einem allgemeinen Agenten sieht eine defekte Schicht zwischen Ihnen und dem Modell genauso aus wie ein Modell, das sich irrt. In einer Pipeline macht ein Schritt einen Modellaufruf mit einer prüfbaren Ausgabe, und man sieht, welcher Teil gelogen hat.
Es gab weitere Reibung dieser Art: Provider-Secrets konnten nicht aus einer Plugin-Quelle kommen, weil der Loader vor der Plugin-Registrierung läuft, und das Dashboard-Session-Token rotierte bei jedem Neustart, sodass jedes Deployment die Desktop-App abmeldete. Nichts davon war fatal. Alles davon waren fremde Entscheidungen zwischen mir und meinen eigenen Aufgaben.
Was ich stattdessen gebaut habe
Das Harness ist bewusst langweilig. Code besitzt den Ablauf, das Modell füllt Schritte aus.
- Skills sind feste Pipelines. Ein Skill ist eine kleine Konfiguration plus ein Prompt, ausgeführt von einem Runner, und jeder Skill hat seine eigene Tool-Allowlist. Kein Skill lässt ein Modell frei über Tools schleifen.
- Eine Tür zu den Modellen. Alles läuft durch ein einziges Modul. Es wendet Alias-Regeln an, eine Freigabe für die teuren Aliase und ein Monatslimit für den stärksten. Die Modelle liegen hinter LiteLLM mit einem virtuellen Schlüssel pro Client, sodass eine neue App nichts ausgeben kann, was ihr nicht zugeteilt wurde.
- Validatoren im Code. Die Debattenshow prüft jede Zahl gegen ihre Quelle, auch ausgeschriebene. Ein Short darf höchstens drei Zahlen enthalten. Wenn ich eine Behauptung erzwinge, die die Quellen nicht stützen, schreibt das Skript „X berichtet“ statt sie als Tatsache zu behaupten.
- Langweilige Speicherung. Die Queues sind SQLite-Tabellen hinter wenigen Funktionen. Ein Digest wird als Outbox bereitgestellt, sodass ein Abbruch mitten im Versand höchstens einen Teil wiederholt. Postgres und eine echte Queue sind ein Austausch hinter dieser einen Datei, den ich vornehme, wenn das Volumen es verlangt.
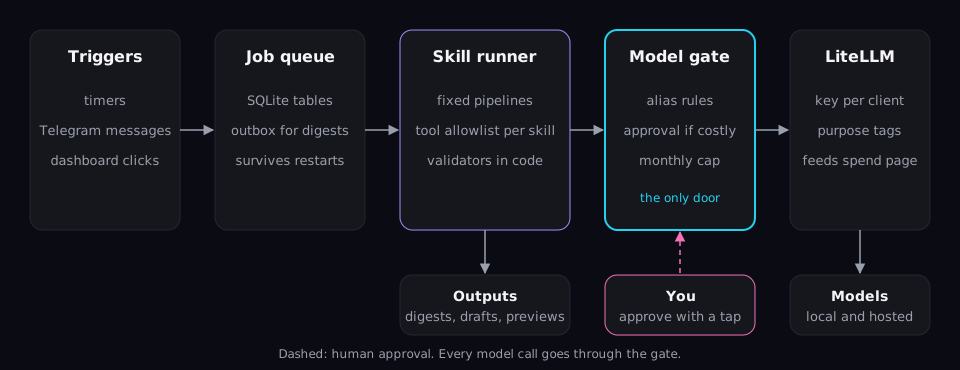
Das Harness auf einen Blick. Alles, was Geld ausgeben kann, läuft durch die Freigabe, und ein Tipp von mir gehört zum Weg.
Eine vereinfachte Skizze der Freigabe, weil Hermes mir genau das nicht geben konnte:
def call(alias, messages, purpose):
    if alias in GATED and not approved(purpose):
        raise ApprovalRequired(alias, purpose)      # wartet auf einen Telegram-Tipp
    if alias == "strong" and month_spend("strong") >= STRONG_CAP:
        raise BudgetExceeded(alias)
    return gateway.complete(alias, messages, tags=[purpose])
Ich habe die Regel in Code gelegt statt in einen Prompt, weil man Code nicht davon abbringen kann. Derselbe Gedanke wanderte später in mein Setup für Coding-Agenten, als Command-Guard, der in einer Konfigurationsdatei lebt und von einem Hook geprüft wird, bevor ein Befehl läuft.
Die Kostenseite zeigt, was das bringt. In den letzten 30 Tagen lagen alle Modellkosten über alle Apps bei 3,66 USD: AgenticTube die Hälfte, die Chat-Oberfläche ein Viertel, mein Memory-Server ein Fünftel, das Harness selbst 3 %, der Fitness-Coach nichts. Hinter jeder Zahl steht ein Purpose-Tag, ich weiß also, wofür sie war.
Warum ich nicht einfach ein SDK übernommen habe
Ich habe mir Strands Agents von AWS angesehen, Open Source, gut gebaut, mit den Multi-Agent-Bausteinen, die ich sonst selbst schreiben müsste. Ich habe entschieden, seine Muster zu übernehmen und das SDK nicht zu verwenden. Direkt auf LiteLLM gerichtet, würde es die einzelne Tür umgehen: keine Freigabe, kein Limit. Falls ich es je ausprobiere, bekommt es einen eigenen Schlüssel, der auf die günstigen Aliase beschränkt ist, mit kleinem Budget.
Das ist für mich das ganze Build-versus-Adopt-Argument. Das, was mir am wichtigsten ist, sitzt genau dort, wo ein Framework seine eigene Schleife hinsetzen will.
Was es ehrlich gekostet hat
- Zeit. Ich habe nachgebaut, was Hermes mitbrachte: die Telegram-Eingangstür, Freigaben, ein Dashboard, eine Job-Queue, nächtliche Backups. Das sind Wochen Arbeit, die vorher nicht nötig waren.
- Offene Aufträge. „Finde auf der Maschine heraus, wie X funktioniert“ war mit Hermes eine normale Bitte. Das Harness kann das nicht. Freitext-Chat, der auf die vorhandenen Skills routet, steht auf meiner Liste und ist nicht gebaut.
- Alles liegt bei mir. Geht etwas kaputt, gibt es keinen Upstream, nur mich.
- Einiges, was mich störte, war behebbar. Den OCR-Bug und die Token-Rotation hätte ich umgehen oder patchen können. Wären das die einzigen Probleme gewesen, würde ich ihn vermutlich noch betreiben. Der eigentliche Grund ist strukturell: Ich wollte Durchsetzung im Code, und ich hatte einen engen Satz an Aufgaben.
Wann ich trotzdem einen allgemeinen Agenten wählen würde
Wenn ich die Aufgaben noch nicht kenne. Hermes war ein guter Weg herauszufinden, was ich automatisieren will, weil ich etwas ausprobieren konnte, ohne etwas zu bauen. Das Harness gibt es nur, weil mir drei Monate davon gezeigt haben, wie die feste Liste aussieht.
Wenn Ihre Arbeit aus einer Handvoll wiederkehrender Pipelines besteht und Sie wissen wollen, wer was ausgeben, senden oder löschen darf, bauen Sie die langweilige Variante. Wenn Sie noch erkunden, fangen Sie allgemein an, schreiben Sie auf, was Sie immer wieder tun, und nehmen Sie den Tag, an dem sich diese Liste nicht mehr ändert, als Signal zum Wechseln.