13. November 2026 · 9 Min. Lesezeit
Mein Videostudio ist Code. Ein neuer Benchmark hat Agenten an derselben Aufgabe getestet.
AgenticStudio ist mein Name für den Code, der meinen YouTube-Kanal produziert. Er erstellt vier Dinge:
- Shorts an den meisten Tagen.
- Einen Digest am Sonntag.
- Eine Cartoon-Debattenshow namens Pick a Side.
- Ein Kit für die Videos, die ich selbst vor der Kamera präsentiere.
Kein einziges Bild stammt aus einem Bild- oder Videomodell. Jede Folie, jedes Diagramm, jede Cartoon-Eule und jeder Untertitel wird von Code gezeichnet. Generiert wird nur die Stimme. Die Fotos sind echte, aus den Artikeln oder einer Stock-Bibliothek.
Letzten Monat hat ein Paper namens VibeVideoBench führende KI-Agenten genau an dieser Art von Arbeit getestet. Es neben meinem eigenen Repo zu lesen, war nützlicher als die meisten Benchmark-Papers, weil es das Problem misst, das ich tatsächlich habe. Dieser Beitrag ist ein Rundgang durch das Studio, gemessen an diesem Paper.
Was VibeVideoBench misst
Die Autoren gehen von einem Punkt aus, dem ich vollständig zustimme. Diffusions-Videomodelle erzeugen beeindruckende Clips, können aber eine exakte Formel, ein korrektes Diagramm oder eine Sprechstimme, die zum Bild passt, nicht zuverlässig darstellen. Der andere Weg ist ein Agent, der Code schreibt, um jedes Bild zu rendern und jeden Ton zu synthetisieren.
Der Aufbau:
- 239 Aufgaben in 12 Kategorien, auf Englisch und Chinesisch, von Datengeschichten und musikgetriebenen Stücken bis zu Unterrichtseinheiten und Paper-Erklärungen.
- Jeder Agent läuft in seinem eigenen Hersteller-Harness, in einer Sandbox ohne Bild- oder Videomodell, und hat eine Stunde, um eine fertige MP4-Datei mit Ton abzuliefern.
- Bewertung in drei Stufen: Programmprüfungen der Lieferspezifikation, dann etwa 13.000 aufgabenspezifische Rubrik-Prüfungen, jede auf die Anforderung zurückgeführt, die sie durchsetzt, dann fünf Qualitätsdimensionen, bewertet von drei Panels aus Vision-Language-Model-Juroren.
Über neun Agentensysteme und 2.151 bewertete Läufe belegten GPT-6 Astra und Claude Opus 5.5 die Plätze eins und zwei, bei den Juroren wie bei blinden menschlichen Bewertern. Das beste System erfüllte bei 76,3 % der Aufgaben jede Kernanforderung.
Zwei Ergebnisse sind wichtiger als die Rangliste:
- Fehlende Videos verändern die Rangliste. Etwa drei Viertel der verlorenen Videos waren finale Renderings, die zu spät begannen, zu langsam liefen oder nie starteten. Die Autoren nennen das ein Versagen darin, wie Agenten ihre Stunde planen.
- Agenten prüfen ihre eigenen Frames, aber wie viel sie hinschauen, sagt nichts über die Qualität aus.
Beides deckt sich mit dem, was ich auf die langsame Art gelernt habe.
Was AgenticStudio produziert
- Shorts. Ein stündlicher Job liest meinen Blog und eine Reihe von Tech-News-Feeds. Ein Modell bewertet jede Meldung: produzieren, den Blickwinkel umschreiben oder überspringen. Ein Short ist etwa eine Minute vertonter, animierter Folien im Look des Kanals und geht erst nach einer finalen Prüfung gegen den Artikel online.
- Der Sonntags-Digest. Er ist 20 bis 30 Minuten lang und erzählt die zwei bis vier Meldungen nach, deren Shorts in den ersten 72 Stunden am besten liefen. Er wird am Sonntagmorgen gebaut und wartet in einem Dashboard auf mich. Hochgeladen wird erst, wenn ich auf Publish klicke.
- Pick a Side. Ich fülle ein Formular aus: die Frage, zwei bis vier Diskutanten und die Seite, die jeder vertritt, dazu ein paar Quellenlinks. Die Pipeline recherchiert das Thema in ein Register zitierter Fakten, schreibt das Skript und rendert ein Cartoon-Studio mit Tieren hinter ihren Pulten und einer Eule als Moderatorin. Die Show fällt nie ein Urteil. Sie endet mit „Which side convinced you? Tell us in the comments.“
- Das Moderations-Kit. Das ist die menschliche Variante. Es macht aus einem Thema ein Recherche-Briefing, ein Teleprompter-Skript und Folien mit einem reservierten Streifen unten für meine Webcam. Nach der Aufnahme richtet es das bekannte Skript mit WhisperX an meiner Stimme aus und schreibt englische Untertitel, dann deutsche, französische und persische Übersetzungen. Ich habe es gebaut, nachdem die gesichtslosen Videos ihren Neuheitswert verloren hatten: Nach der ersten Woche klickten die Zuschauer nicht mehr.
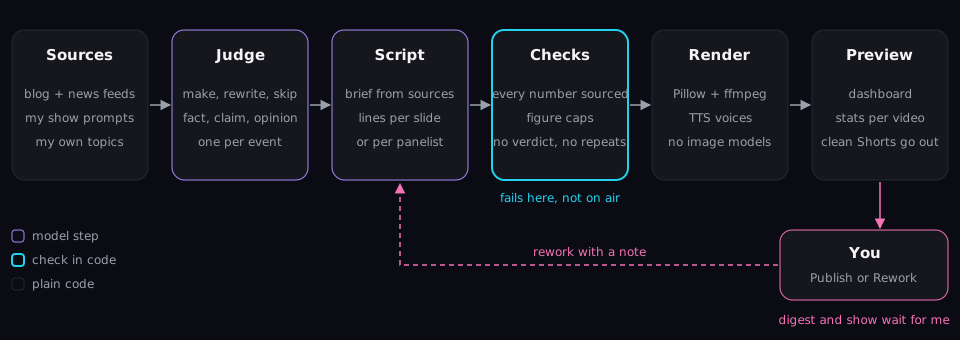
Jedes Format hat dieselbe Form. Die Modelle füllen Schritte aus, Code prüft sie. Ein Short geht nur von selbst online, wenn jede Prüfung besteht; Digest und Show warten immer auf meinen Klick.
Die Render-Seite ist schlicht: Pillow zeichnet die Folien, ffmpeg animiert freigestellte Ebenen und mischt den Ton. Ich habe langweilige Werkzeuge gewählt, weil sie deterministisch sind. Dasselbe Skript ergibt dasselbe Video, also lässt sich ein Fehler reproduzieren und eine Korrektur testen.
Die Stimmen sind Googles Chirp 3 HD TTS. Sie haben Eigenheiten, die kein Benchmark auflisten würde: Chirp buchstabiert „Hmph“ und „Pfft“ Buchstabe für Buchstabe, also spotten die Diskutanten stattdessen mit „Oh, please“ und „Yeah, right“. Ein echtes Lachen kommt von einem zweiten TTS-Modell, das ein [laughing]-Tag versteht.
Alles läuft auf demselben dauerhaft laufenden Mini-PC wie mein Agenten-Harness. Über 30 Tage machte AgenticTube, der automatische Teil, etwa die Hälfte der 3,66 USD aus, die meine Apps für Modelle ausgegeben haben. Sprachsynthese wird separat abgerechnet.
Wo Paper und Studio übereinstimmen: Code zeichnet exakte Dinge
Das Eingangsargument des Papers ist seit Version eins die erste Regel des Studios: keine KI-Bilder und keine erfundenen Zahlen. Ein Diagramm wird aus Werten gezeichnet, die aus der Quelle stammen, also kann ein Diagramm nicht halluzinieren.
Bei der Synchronisation ist es dasselbe. Chirp akzeptiert keine Zeitmarken, ich bekomme also keine Wort-Zeitstempel. Der Moment jeder Karte wird stattdessen berechnet: wo ihre Wörter zuerst im Text vorkommen, als Anteil am Text, mal die Länge des Audios. Das ist auf etwa eine halbe Sekunde genau, genug, damit eine Karte erscheint, während der Sprecher sie ausspricht. Ein Diffusionsmodell müsste das raten.
Wo sie sich unterscheiden, Teil 1: Meine Agenten planen ihre Stunde nicht
Die Agenten im Paper bauen innerhalb eines Budgets von einer Stunde eine Render-Pipeline von Grund auf, und die meisten verlorenen Videos sterben beim Rendern. Meine stehen nie vor dieser Entscheidung, weil die Pipeline fest ist und ihre Kosten bekannt sind:
- Ein Short rendert in etwa 22 Sekunden.
- Eine 12-minütige Debattenfolge braucht etwa zwei Minuten auf sechs Workern.
- Ein Testbuild eines 26-minütigen Digests dauerte 20,5 Minuten Echtzeit und 2 Stunden 24 Minuten CPU, bei einem Limit von 3 Stunden für den Job.
Diese Zahlen kenne ich nur, weil ich probe: eine Kopie der Live-Datenbank in einer Sandbox, ein Fake-YouTube-Client und die echten Einstellungen des Jobs. In meinem Studio schreibt das Modell die Worte. Zeitplanung, Wiederholungen und das Rendering sind schlichter Code.
Das ist derselbe Schluss, zu dem ich bei allgemeinen Agenten gegenüber festen Pipelines gekommen bin, jetzt mit einem Benchmark im Rücken. Wenn die Aufgabe bekannt ist, fügt es nur eine Fehlerquelle hinzu, ein Modell sie bei jedem Lauf neu planen zu lassen, ohne etwas zu gewinnen.
Wo sie sich unterscheiden, Teil 2: Rubrik-Prüfungen oder Schranken
VibeVideoBench bewertet jedes Video im Schnitt gegen etwa 54 Rubrik-Prüfungen, jede auf eine Anforderung zurückgeführt. Das ist die richtige Idee, und ich mache dasselbe, nur laufen meine Prüfungen vor der Veröffentlichung und blockieren sie:
- Jede Zahl auf dem Bildschirm oder im Ton muss nach Wert und Einheit zu einem zitierten Fakt passen. Das gilt auch für ausgeschriebene Zahlen, „zwei Drittel von“, „5 Mrd. $“ und „10x“.
- Höchstens drei Zahlen pro Short, weil das Briefing des Modells jede Zahl aus dem Artikel herauszieht und die ersten Skripte wie Quartalsberichte klangen.
- Jeder Short endet mit einer neutralen Frage.
- Die Debatte fällt nie ein Urteil und gibt keinen Rat.
- Ein Diskutant darf einen Fakt in höchstens zwei Zeilen zitieren. Kein Satz darf 60 % oder mehr seiner Inhaltswörter mit einem teilen, den dieser Diskutant schon gesagt hat.
Keine dieser Regeln stammt aus einer Spezifikation. Jede kam vom Anschauen einer Folge. Die Wiederholungsregel gibt es, weil eine Folge denselben Fakt in 13 Zeilen desselben Diskutanten zitierte. Eine Rubrik sagt Ihnen hinterher, dass ein Video durchgefallen ist. Eine Schranke sagt der Pipeline, es noch einmal zu versuchen, bevor es jemand sieht.
Wo sie sich unterscheiden, Teil 3: Hinschauen ist nicht Qualität
Das Ergebnis des Papers, dass die Menge des Hinschauens nichts über die Qualität aussagt, würde ich unterstreichen. Meine eigene Version: Pixeltests haben vier echte visuelle Fehler durchgelassen. Die Tests prüften, dass jeder Frame gerendert wurde, Inhalt hatte und in sein Layout passte. Keiner bemerkte ein Foto, das zum Vorschaubild geschrumpft war, oder eine Überschrift, die abgeschnitten war, obwohl Platz frei war.
Gefunden hat sie ein Kontaktbogen echter Renderings, den ich mir nach jeder Änderung angesehen habe. Und dann gibt es Dinge, von denen keine Frame-Prüfung weiß. YouTube legt Kanalname, Titel und den Abonnieren-Button über den unteren Teil eines Shorts, und die veröffentlichten Werte für diese Sicherheitszone widersprechen sich. Mein Inhalt bleibt jetzt oberhalb von Zeile 1520 von 1920 und 140 Pixel von beiden Rändern entfernt, und die letzte Prüfung war das Telefon in meiner Hand.
Was kein Benchmark misst: ob jemand zuschaut
Jetzt der ehrliche Teil. Eine Zeit lang bekamen Shorts zu schweren Themen 2 bis 37 Aufrufe, und von jedem wurden 0 bis 7 % angesehen. Ein Freund außerhalb der Tech-Welt sagte mir, die Erklärungen seien schwer zu verstehen. Jeder dieser Shorts hätte eine strenge Rubrik bestanden.
Also habe ich den Kanal auf diesen Freund ausgerichtet:
- Allgemeine News-Feeds statt der meisten Engineering-Blogs von Herstellern.
- Ein Short pro Ereignis.
- Behauptungen warten auf eine offizielle Stellungnahme oder ein zweites unabhängiges Medium; Meinungen werden übersprungen.
- Höchstens drei Zahlen und kein unerklärter Fachjargon.
Diese Änderung war eine Entscheidung über ein Publikum, keine Korrektur einer Pipeline. Ein Benchmark kann sagen, ob ein Agent 76 % einer Spezifikation erfüllt hat. Er kann Ihnen nicht sagen, ob die Spezifikation es wert war, erfüllt zu werden. Deshalb enden die langen Formate immer noch mit meinem Klick auf Publish oder Rework, und deshalb wartet auch ein Short, der eine Prüfung nicht besteht, auf mich.
Das Paper mit Vorsicht lesen
- Jeder Agent lief in seinem eigenen Hersteller-Harness, also bewertet die Rangliste ein Modell und sein Harness zusammen. Ein gutes Modell in einem schwachen Harness und ein schwaches Modell in einem guten lassen sich nicht auseinanderhalten.
- Die Rangliste der Juroren stimmte mit blinden menschlichen Präferenzen überein. Das ist eine Aussage über die Rangfolge von Systemen, kein Beweis, dass ein Juror ein einzelnes Video freigeben kann. Der Publish-Button bleibt.
- Ich habe das Abstract und eine Rezension von dritter Seite gelesen, nicht das ganze Paper. Die Zahlen oben stammen aus dem Abstract.
Was ich daraus mitnehme
Das Paper gibt etwas einen Namen, das ich bisher nur gespürt hatte: Lieferung ist eine eigene Achse. Ein Video, das zu 90 % gut ist und ankommt, ist mehr wert als ein perfektes, das nie fertig gerendert wird. Feste Pipelines gewinnen diese Achse von selbst, und das ist der Hauptgrund, warum AgenticStudio so aussieht, wie es aussieht.
Was ich übernehmen will, ist die Rückverfolgbarkeit. Jede Rubrik-Prüfung in VibeVideoBench verweist auf die Anforderung, die sie durchsetzt. Meine Schranken sagen noch nicht, aus welcher meiner Entscheidungen sie stammen, und nach fünf Monaten voller Regeln, die mit „mir ist aufgefallen“ begannen, sollten sie das.