۲۲ آبان ۲۵۸۵ · 10 دقیقه مطالعه
استودیوی ویدیوی من کده. یه بنچمارک جدید ایجنتها رو روی همین کار سنجید.
اسمی که روی کدِ سازندهی کانال یوتیوبم گذاشتم AgenticStudio هست. این کد چهار چیز میسازه:
- تقریباً هر روز شورت.
- یه دایجست یکشنبهها.
- یه برنامهی مناظرهی کارتونی به اسم Pick a Side.
- یه جعبهابزار برای ویدیوهایی که خودم جلوی دوربین اجرا میکنم.
حتی یه فریم هم از مدل تصویر یا ویدیو نمیاد. همهی اسلایدها، نمودارها، جغدهای کارتونی و زیرنویسها رو کد میکشه، و تنها رسانهای که مدل تولیدش میکنه صداست. عکسها واقعیان، از خود مطلبها یا از یه بانک عکس.
ماه پیش مقالهای به اسم VibeVideoBench پیشرفتهترین ایجنتهای هوش مصنوعی رو دقیقاً روی همین نوع کار سنجید. خوندنش کنار ریپوی خودم از بیشتر مقالههای بنچمارک مفیدتر بود، چون همون مشکلی رو میسنجه که من واقعاً دارم. تو این پست استودیو رو نشونت میدم و کنار یافتههای اون مقاله میذارمش.
بنچمارک VibeVideoBench چی رو میسنجه
نویسندهها از نکتهای شروع میکنن که من کاملاً قبولش دارم. مدلهای دیفیوژنی ویدیو کلیپهای چشمگیری میسازن، ولی نمیتونن با اطمینان یه فرمول دقیق، یه نمودار درست، یا روایتی که با تصویر روی صفحه هماهنگ باشه رندر کنن. راه دیگه ایجنتیه که کد مینویسه تا هر فریم رو رندر کنه و هر صدا رو بسازه.
چیدمان آزمون:
- ۲۳۹ تسک در ۱۲ دسته، به انگلیسی و چینی، از داستانهای دادهمحور و کارهایی که با موسیقی پیش میرن تا درسهای کلاسی و ویدیوهایی که یه مقاله رو توضیح میدن.
- هر ایجنت توی هارنس خودِ سازندهش اجرا میشه، داخل یه محیط ایزوله بدون هیچ مدل تصویر یا ویدیویی، و یک ساعت وقت داره تا یه MP4 کامل با صدا تحویل بده.
- نمرهدهی در سه سطح: اول چکهای برنامهای روی مشخصات تحویل، بعد حدود ۱۳٬۰۰۰ چک روبریک مخصوص هر تسک که هر کدوم به نیازمندیای که اعمال میکنه وصله، و در آخر پنج جنبهی کیفیت که سه هیئت داوری از مدلهایی که هم تصویر میفهمن هم متن بهشون نمره میدن.
در بین نُه سیستم ایجنتی و ۲٬۱۵۱ اجرای نمرهگرفته، مدلهای GPT-6 Astra و Claude Opus 5.5 اول و دوم شدن، هم از نظر داورهای مدل، هم از نظر ارزیابهای انسانیای که نمیدونستن کدوم خروجی مال کدوم سیستمه. بهترین سیستم توی ۷۶٫۳٪ تسکها همهی نیازمندیهای اصلی رو برآورده کرد.
دو تا یافته از خود رتبهبندی مهمترن:
- ویدیوهای تحویلنشده رتبهبندی رو عوض میکنن. حدود سهچهارم ویدیوهای از دست رفته رندرهای نهاییای بودن که خیلی دیر شروع شدن، خیلی کند پیش رفتن یا اصلاً شروع نشدن. نویسندهها اسمش رو گذاشتن شکست ایجنتها در برنامهریزی همون یک ساعت.
- ایجنتها فریمهای خودشون رو بررسی میکنن، ولی میزان نگاه کردنشون کیفیت رو پیشبینی نمیکنه.
هر دو با چیزی که خودم با کلی دردسر یاد گرفتم جور درمیاد.
استودیوی AgenticStudio چی میسازه
- شورتها. یه کار ساعتی بلاگم و یه سری فید خبری تکنولوژی رو میخونه. یه مدل دربارهی هر خبر تصمیم میگیره: بسازش، زاویهش رو عوض کن، یا ازش بگذر. هر شورت حدود یه دقیقه اسلاید متحرک با صدای گویندهست، به سبک ظاهری کانال، و فقط بعد از یه چک نهایی در برابر مطلب اصلی عمومی میشه.
- دایجست یکشنبه. بین ۲۰ تا ۳۰ دقیقهست و دو تا چهار خبری رو که شورتشون توی ۷۲ ساعت اول بهتر از همه دیده شده دوباره تعریف میکنه. یکشنبه صبح ساخته میشه و توی یه داشبورد منتظرم میمونه. تا وقتی روی Publish کلیک نکنم هیچچیز آپلود نمیشه.
- برنامهی Pick a Side. یه فرم پر میکنم: سؤال، دو تا چهار مهمان و طرفی که هر کدوم ازش دفاع میکنه، بهعلاوهی چند تا لینک منبع. پایپلاین دربارهی موضوع تحقیق میکنه و یه دفتر از واقعیتهای نقلقولشده میسازه، متن رو مینویسه و یه استودیوی کارتونی رندر میکنه که توش مهمانها حیوونهاییان که پشت میز نشستن و یه جغد مجریه. برنامه هیچوقت حکم نمیده. با این جمله تموم میشه: «کدوم طرف قانعت کرد؟ توی کامنتها بهمون بگو.»
- جعبهابزار مجری. این نسخهی انسانیه. یه موضوع رو تبدیل میکنه به یه خلاصهی تحقیق، یه متن تلهپرامپتر و اسلایدهایی که پایینشون یه نوار برای تصویر وبکمم کنار گذاشته شده. بعد از اینکه ضبط کردم، متنی رو که از قبل معلومه با WhisperX با صدام همتراز میکنه و زیرنویس انگلیسی مینویسه، بعد ترجمههای آلمانی، فرانسوی و فارسی. این رو بعد از این ساختم که ویدیوهای بیچهره تازگیشون رو از دست دادن: بینندهها بعد از هفتهی اول دیگه کلیک نکردن.
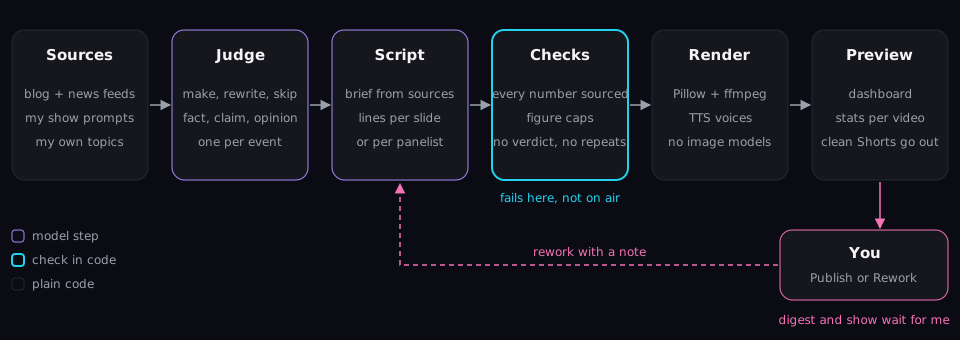
همهی قالبها یه شکل دارن. مدلها مرحلهها رو پر میکنن و کد اونها رو چک میکنه. شورت فقط وقتی خودش منتشر میشه که همهی چکها پاس بشن؛ دایجست و برنامهی مناظره همیشه منتظر کلیک من میمونن.
بخش رندر سادهست: کتابخونهی Pillow اسلایدها رو میکشه، و ابزار ffmpeg لایههای ماسکدار رو متحرک میکنه و صدا رو میکس میکنه. ابزارهای بیهیجان رو انتخاب کردم چون خروجیشون قطعیه. همون اسکریپت همون ویدیو رو رندر میکنه، پس میشه یه باگ رو بازتولید کرد و یه فیکس رو تست کرد.
صداها رو سرویس تبدیل متن به گفتار گوگل، یعنی Chirp 3 HD، میسازه. این صداها ادا و اطوارهایی دارن که هیچ بنچمارکی فهرستشون نمیکنه: این مدل کلمههایی مثل «Hmph» و «Pfft» رو حرف به حرف هجی میکنه، برای همین مهمانها بهجاش با «Oh, please» و «Yeah, right» پوزخند میزنن. یه خندهی واقعی هم از یه مدل TTS دوم میاد که تگ [laughing] رو میفهمه.
همهش روی همون مینیپیسی همیشهروشنی اجرا میشه که هارنس ایجنتم هم روشه. توی ۳۰ روز، AgenticTube، یعنی بخش خودکار ماجرا، حدود نصفِ ۳٫۶۶ دلاری بود که اپهام خرج مدلها کردن. هزینهی تبدیل متن به گفتار جداگانه حساب میشه.
جایی که مقاله و استودیو همنظرن: کد چیزهای دقیق رو میکشه
استدلال آغازین مقاله از نسخهی اول، قانون اول استودیو بوده: نه تصویر ساختهی هوش مصنوعی، نه عدد مندرآوردی. هر نمودار از مقدارهایی کشیده میشه که از منبع اومدن، پس نمودار نمیتونه توهم بزنه.
هماهنگی صدا و تصویر هم همین داستان رو داره. به مدل Chirp نمیشه نشونهی زمانبندی داد، پس تایماستمپ کلمهها رو هم ندارم. بهجاش لحظهی هر کارت حساب میشه: جایی که کلمههاش اولین بار توی متن میان، بهصورت سهمی از کل متن، ضرب در طول صدا. دقتش حدود نیم ثانیهست، که کافیه تا کارت درست همون لحظهای برسه که گوینده داره اون رو میگه. یه مدل دیفیوژنی مجبور بود این رو حدس بزنه.
جایی که فرق دارن، بخش ۱: ایجنتهای من ساعتشون رو برنامهریزی نمیکنن
ایجنتهای مقاله توی یه بودجهی زمانی یکساعته یه پایپلاین رندر رو از صفر میسازن، و بیشتر ویدیوهایی که از دست میدن موقع رندر میمیرن. ایجنتهای من هیچوقت با این تصمیم روبهرو نمیشن، چون پایپلاین ثابته و هزینههاش معلومه:
- یه شورت توی حدود ۲۲ ثانیه رندر میشه.
- یه قسمت ۱۲ دقیقهای از برنامهی مناظره با شش ورکر حدود دو دقیقه طول میکشه.
- یه بیلد آزمایشی از یه دایجست ۲۶ دقیقهای ۲۰٫۵ دقیقه زمان واقعی و ۲ ساعت و ۲۴ دقیقه زمان CPU گرفت، در برابر سقف ۳ ساعتهای که اون کار داره.
این عددها رو فقط به این خاطر میدونم که تمرین میکنم: یه کپی از دیتابیس زنده توی یه محیط ایزوله، یه کلاینت یوتیوب قلابی، و تنظیمات خودِ کار واقعی. توی استودیوی من، مدل کلمهها رو مینویسه. زمانبندی، تلاشهای دوباره و رندر کد سادهان.
این همون نتیجهایه که دربارهی ایجنتهای همهمنظوره در برابر پایپلاینهای ثابت گرفته بودم، حالا با یه بنچمارک پشتش. وقتی کار معلومه، اینکه هر بار از مدل بخوای برنامهریزیش کنه یه راه شکست اضافه میکنه که هیچی در عوض نمیده.
جایی که فرق دارن، بخش ۲: چک روبریک یا گیت
بنچمارک VibeVideoBench هر ویدیو رو بهطور میانگین با حدود ۵۴ چک روبریک میسنجه که هر کدوم به یه نیازمندی وصله. ایدهی درستیه، و من هم همین کار رو میکنم، با این فرق که چکهای من قبل از انتشار اجرا میشن و جلوش رو میگیرن:
- هر عددی که روی صفحه میاد یا گفته میشه باید از نظر مقدار و واحد با یه واقعیت مستند جور باشه. این شامل عددهایی که با حروف نوشته شدن و عبارتهایی مثل «two thirds of»، «$5bn» و «10x» هم میشه.
- حداکثر سه عدد در هر شورت، چون بریفی که مدل میگیره همهی عددهای مطلب رو بیرون میکشه، و متنهای اولیه عین جلسههای گزارش درآمد فصلی شرکتها بودن.
- هر شورت با یه سؤال بیطرف تموم میشه.
- برنامهی مناظره هیچوقت حکم یا توصیه نمیده.
- هر مهمان یه واقعیت رو حداکثر توی دو خط میتونه نقل کنه. هیچ جملهای نباید ۶۰٪ یا بیشتر از کلمههای محتواییش رو با جملهای که همون مهمان قبلاً گفته مشترک داشته باشه.
هیچکدوم از اینها از یه سند مشخصات نیومده. هر کدوم از تماشای یه قسمت اومده. قانون تکرار به این خاطر وجود داره که توی یه قسمت، یه مهمان همون واقعیت رو توی ۱۳ خط نقل کرد. روبریک بعداً بهت میگه یه ویدیو شکست خورده. گیت به پایپلاین میگه قبل از اینکه کسی ببینه، دوباره تلاش کنه.
جایی که فرق دارن، بخش ۳: نگاه کردن یعنی کیفیت نیست
این یافتهی مقاله که میزان نگاه کردن ایجنتها کیفیت رو پیشبینی نمیکنه، همونیه که من زیرش خط میکشم. نسخهی خودم: چهار تا ایراد بصری واقعی از تستهای پیکسلی رد شدن. تستها چک میکردن که هر فریم رندر شده باشه، محتوا داشته باشه و توی چیدمانش جا بشه. هیچکدومشون متوجه نشدن که یه عکس تا اندازهی یه تصویر بندانگشتی کوچیک شده، یا یه تیتر بریده شده در حالی که کلی جا بوده.
چیزی که پیداشون کرد یه برگه از تصویرهای کوچیکِ رندرهای واقعی بود که بعد از هر تغییر نگاهش میکردم. بعد چیزهایی هستن که هیچ چک فریمی ازشون خبر نداره. یوتیوب اسم کانال، عنوان و دکمهی Subscribe رو روی پایین شورت میکشه، و عددهایی که برای این منطقهی امن منتشر شده با هم نمیخونن. حالا محتوای من بالای ردیف ۱۵۲۰ از ۱۹۲۰ و ۱۴۰ پیکسل دور از هر دو لبه میمونه، و چک نهایی این بود که گوشی رو دستم بگیرم.
چیزی که هیچ بنچمارکی نمیسنجه: اینکه کسی تماشا میکنه یا نه
این بخش صادقانهی ماجراست. یه مدت، شورتهایی با موضوعهای سنگین ۲ تا ۳۷ بازدید میگرفتن، و از هر کدوم ۰ تا ۷٪ دیده میشد. یه دوست بیرون از دنیای تکنولوژی بهم گفت دنبال کردن توضیحها سخته. همهی اون شورتها یه روبریک سختگیرانه رو پاس میکردن.
برای همین مخاطب هدف کانال رو همون دوست گذاشتم:
- فیدهای خبری عمومی بهجای بیشتر بلاگهای مهندسی شرکتهای سازنده.
- یه شورت برای هر رویداد.
- ادعاها منتظر یه بیانیهی رسمی یا یه رسانهی مستقل دوم میمونن؛ نظرها کنار گذاشته میشن.
- حداکثر سه عدد، و هیچ اصطلاح فنی توضیحدادهنشدهای.
این تغییر تصمیمی دربارهی مخاطب بود، نه فیکس یه پایپلاین. بنچمارک میتونه بگه یه ایجنت ۷۶٪ یه مشخصات رو برآورده کرده یا نه. نمیتونه بهت بگه اون مشخصات ارزش برآورده شدن داشته یا نه. برای همینه که قالبهای بلند هنوز با کلیک من روی Publish یا Rework تموم میشن، و برای همینه که شورتی که یکی از چکها رو پاس نکنه هم منتظر من میمونه.
خوندن مقاله با احتیاط
- هر ایجنت توی هارنس خودِ سازندهش اجرا شد، پس رتبهبندی به مدل و هارنسش با هم نمره میده. یه مدل خوب توی یه هارنس ضعیف و یه مدل ضعیف توی یه هارنس خوب از هم تشخیص داده نمیشن.
- رتبهبندی داورها با ترجیح ارزیابهای انسانیای که نمیدونستن کدوم خروجی مال کیه جور بود. این حرفیه دربارهی رتبهبندی سیستمها، نه اثبات اینکه یه داور میتونه یه ویدیوی تکی رو تأیید کنه. دکمهی Publish سر جاش میمونه.
- من چکیده و یه نقد از یه منبع مستقل رو خوندم، نه کل مقاله رو. عددهای بالا از چکیده اومدن.
چی ازش برمیدارم
مقاله برای چیزی اسم گذاشت که من فقط حسش کرده بودم: تحویل یه محور جداگانهست. ویدیویی که ۹۰٪ خوبه و به مقصد میرسه، از یه ویدیوی بینقص که رندرش هیچوقت تموم نمیشه ارزش بیشتری داره. پایپلاینهای ثابت این محور رو بهطور پیشفرض میبرن، و بیشتر دلیل اینکه AgenticStudio این شکلیه همینه.
بخشی که میخوام ازش کش برم ردیابیپذیریه. هر چک روبریک توی VibeVideoBench به نیازمندیای که اعمال میکنه اشاره میکنه. گیتهای من هنوز نمیگن از کدوم تصمیم من اومدن، و بعد از پنج ماه قانونهایی که با «متوجه شدم» شروع شدن، دیگه وقتشه که بگن.